Notes-Learning to write kernels on a GPU
0. 参考资料
1. Prerequisites: UIUC ECE408/CS483/CSE408 Applied Parallel Programming
1.1 Introduction
一个并行计算的Workflow应该是怎样的?
- [ ] 识别一个算法/应用的计算密集部分
- [ ] 创建/调整一个可扩展的算法
- [ ] 优化数据编排方式,使其最大化数据的局部性
- [ ] 性能调整(针对内存和处理单元之间的带宽)
- [ ] 关注代码的可移植性,可扩展性和可维护性
大规模并行计算的管理:规律性(Regularity)
负载均衡
并行任务的执行总时间取决于最长运行时间的线程。
全局的内存带宽
数据访问冲突导致的串行和延迟
1.2 CUDA/OpenCL Execution Model
两者的模型是一样的,只是处理方式些许不同。都是Host+device integrated app C/C++ 程序,即整个代码是包含了Host和Device的执行过程的,不用分成两个文件。程序中的关键字会规定这些代码隶属于Host还是Device还是二者共同的。Host的函数中会调用Kernel Call,用来做执行大规模并行化的入口。
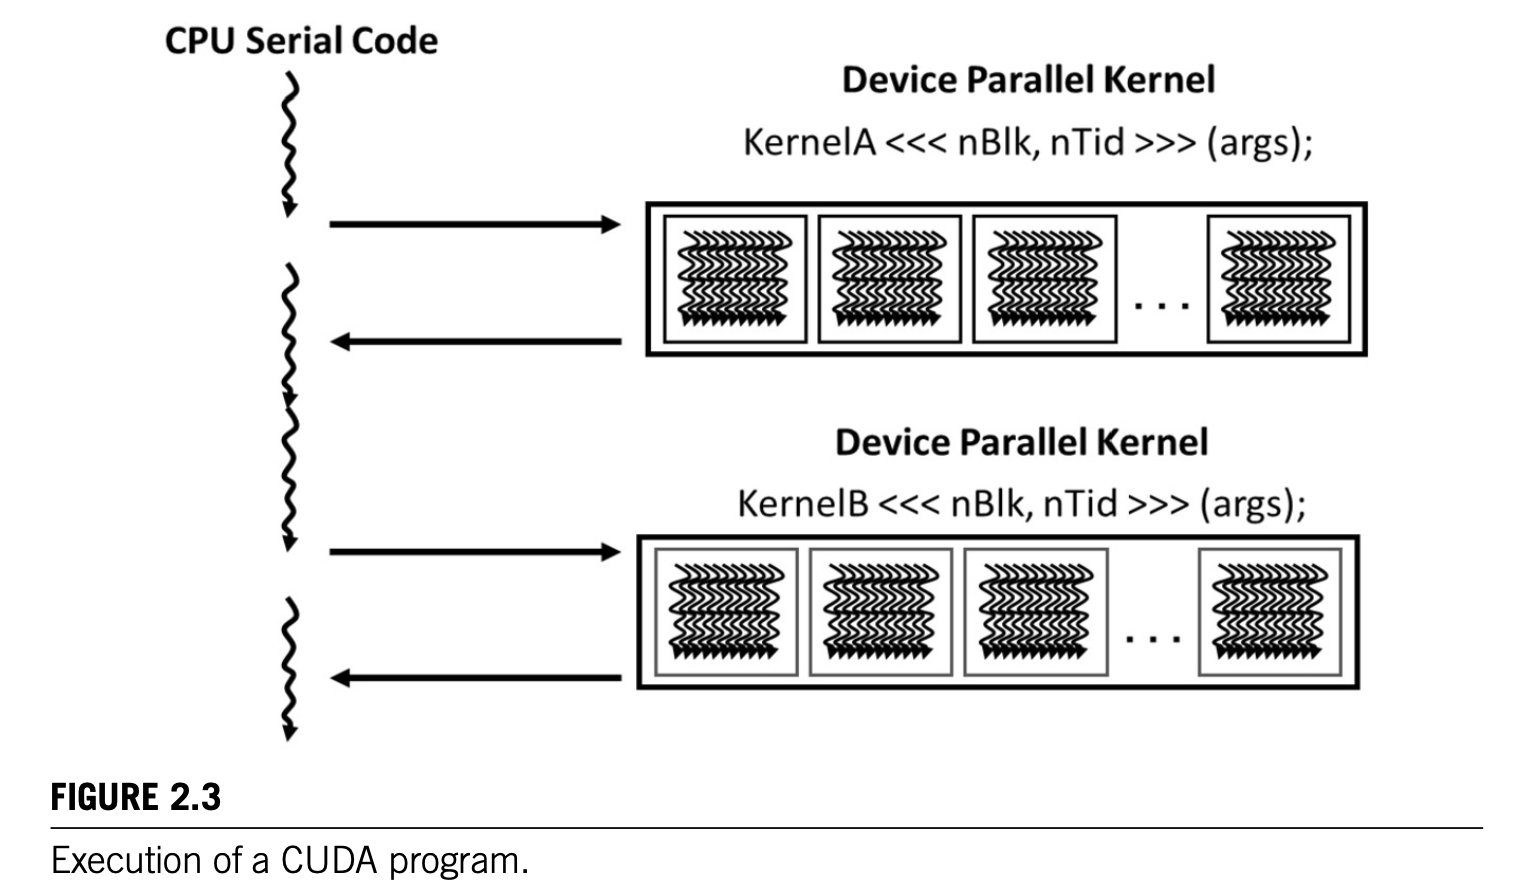
在Kernel Call Func.里,规定两个参数:nBlk【生成多少个线程块(Thread Block)】和nTid【每个线程块有多少个线程】。之前提到的Regularity体现在每一个线程块中的线程数量是一样的。这是一个很规则的执行模式。二者的集合就叫做Grid of Threads(线程网格)。CUDA采用的指令模式是单程序多数据(SPMD)
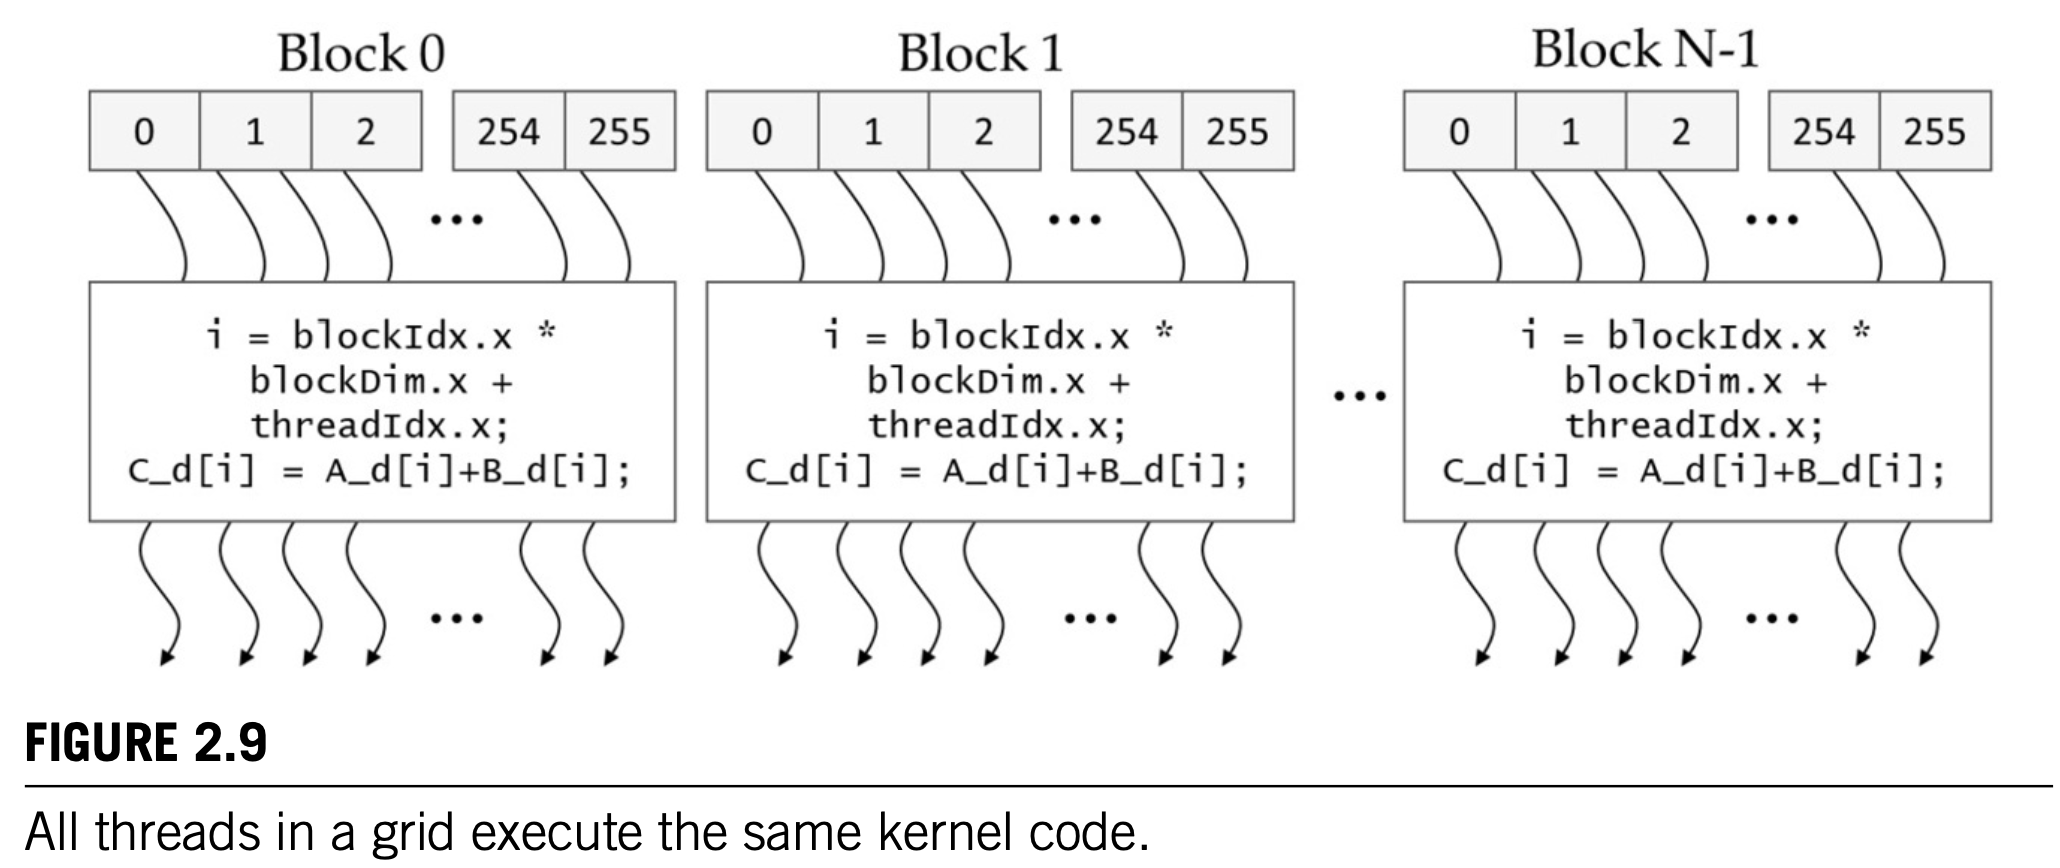
blockDim是每一个线程块允许的最大线程个数。blockIdx和threadIdx是线程块和内部线程的索引。.x/.y/.z用于适配不同的数据维度,便于代码阅读。
在CUDA中,代码本身不像是一个执行者(executor),更像是一个监督者(supervisor)。整个代码在监督一个外源的设备(outsourced device,即GPU)来进行大规模并行计算。包括以下几个步骤:分配外源设备内存、描述计算逻辑、将结果复制到Host里。
1.2.1 分配内存
和CPU一样,GPU设备也有访问非常迅速并且访问开销很小的寄存器(Registers)。这些寄存器是通过线程的指令访问。同时,也有一块全局内存(Global memory),供所有线程都可以访问的一片内存空间。
R/W per-thread registers
R/W per-grid global memory
Host的代码/程序可以将数据搬移到这一片Global shared memory里,供GPU device的thread grid来读写。
选择不同的存储访存,与其带宽有关。不同场景下会根据设备寄存器/全剧内存空间的带宽不同,做出不同的策略。
内存管理的API函数
cudaMalloc(): 用于在Device侧的Global Memory中分配对象。传入两个参数:第一个是指向已分配对象的指针的地址,第二个是分配对象的字节数(对象大小)。每个单精度浮点数是4BytescudaFree(); 用于释放对象占用的设备空间。传入一个参数:对象的指针(而非该指针的地址)cudaMemcpy(): 用于Host和Device的内存数据迁移(复制),传入四个参数:目的指针、原指针、拷贝的字节数、数据迁移的方向/类型
1.2.2 kernel调用
以一个vecAdd为例:
1 | /////////Host Code///////// |
| Functions with keywords | Exec. on the: | only callable from the: |
|---|---|---|
__device__ float DeviceFunc() |
device | device |
__global__ void KernelFunc() |
device (must return void) |
host |
__host__ float HostFunc() |
host | host |
1.2.3 CUDA程序的编译过程
1.3 Kernel-based Data Parallel Execution Model
1.3.1 CUDA 线程块是多维的
 wechat
- alipay